11.2. Dataflow engines, joins e usos do batch (ETL e ML)
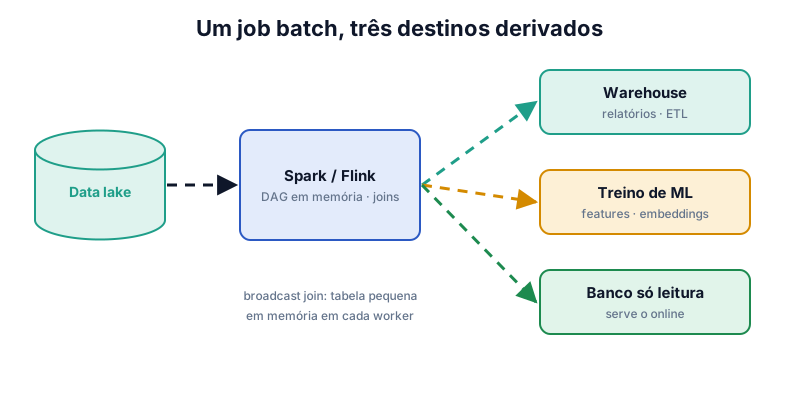
Spark e Flink substituem MapReduce com DAGs em memória; batch alimenta warehouses, modelos de ML e serviços.
Resumo
- Dataflow engines (Spark, Flink): DAG inteiro de operadores, dados em memória entre etapas; mais rápido que MapReduce.
- Joins em batch: sort-merge (ordena e une pelas chaves), broadcast hash join (tabela pequena em memória em cada nó).
- Chave quente (skew): dividir a chave entre vários workers. Shuffle é a operação mais cara: evite quando puder.
- APIs: SQL e DataFrames (Pandas, Spark, Polars) no mesmo motor. Otimizador escolhe o plano.
- Usos: ETL, análise, treino de ML (features, embeddings em lote) e servir dados derivados (gerar banco só leitura).
Perguntas-chave
responda de cabeça, depois abraQuando usar broadcast hash join?
Quando um dos lados é pequeno o suficiente para caber na memória de cada worker; evita ordenar e embaralhar o lado grande.
Como um batch serve dados a um sistema online?
Gerando arquivos de banco prontos (ex.: chave-valor só leitura) e trocando a versão em uso de forma atômica, sem escrever registro a registro no banco de produção.
Por que treinar modelos de ML é um caso de batch?
Lê grandes volumes históricos, calcula features e gera um artefato (o modelo), que é dado derivado e pode ser recriado.
Exercícios de fixação
0/5 respondidas1.
Juntar 2 bilhões de eventos com uma tabela de 500 países. Qual join é mais eficiente?
2.
Qual a maior vantagem do Spark sobre o MapReduce clássico?
3.
Um sistema de recomendação recalcula, toda noite, embeddings de todos os produtos e grava num índice vetorial novo. Esse job é:
4.
Gravar o resultado de um batch registro a registro no banco de produção é desaconselhado porque:
5.
Um usuário tem 100 vezes mais eventos que os outros e trava um reducer. Como lidar com o skew?