11.1. Batch: Unix, object stores e MapReduce
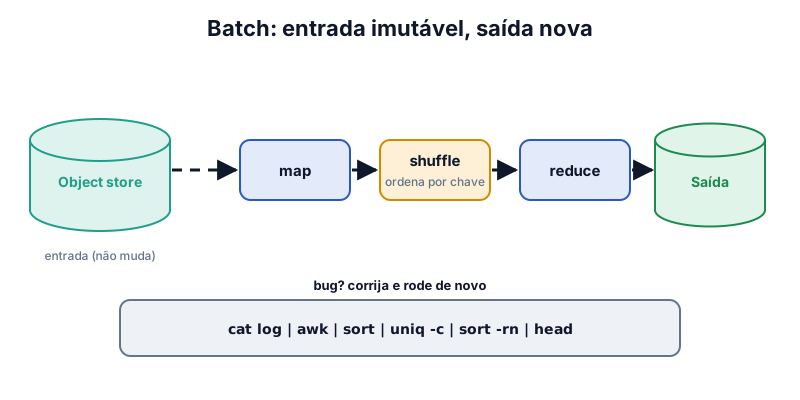
Batch lê uma entrada imutável e grande, gera uma saída nova; rodar de novo é seguro.
Resumo
- Batch: processa um volume fixo de entrada e produz saída; medido por vazão, não latência. Ex.:
sort | uniq -c. - Filosofia Unix: programas pequenos, interface uniforme (arquivos), entrada imutável, composição por pipes.
- Sistemas de arquivos distribuídos (HDFS) e object stores (S3): guardam a entrada e a saída dos jobs.
- Orquestração: agendador (YARN, Kubernetes) aloca recursos; workflow (Airflow, Dagster) encadeia jobs em DAG.
- MapReduce: map extrai chave-valor, shuffle ordena por chave, reduce agrega. Saída imutável: falhou, roda de novo.
Perguntas-chave
responda de cabeça, depois abraPor que entrada imutável é tão útil no batch?
Se o job tiver bug ou falhar, basta corrigir e rodar de novo; a entrada continua intacta e a saída antiga pode ser descartada.
O que acontece no shuffle?
Os pares chave-valor gerados pelos mappers são particionados e ordenados por chave, para que cada reducer receba todos os valores de uma mesma chave.
Qual a diferença entre agendador e orquestrador de workflow?
O agendador decide em que máquinas cada tarefa roda; o orquestrador decide a ordem e as dependências entre jobs.
Exercícios de fixação
0/5 respondidas1.
Um job noturno gerou relatórios com erro por bug. Como o modelo batch facilita a correção?
2.
Em
cat log | awk '{print $7}' | sort | uniq -c | sort -rn | head, qual parte faz o papel do shuffle?3.
Qual métrica importa mais num job batch?
4.
Airflow ou Dagster servem para:
5.
Por que object stores como S3 viraram a base de muitos pipelines batch?