3.2. Grafos, event sourcing e DataFrames
Grafos para relações livres; eventos imutáveis como fonte; DataFrames e arrays para análise e ML.
Resumo
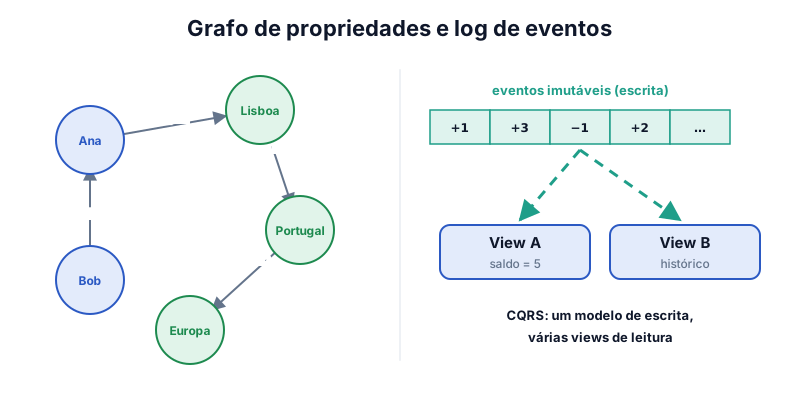
- Grafo de propriedades: vértices e arestas com rótulo e propriedades. Consultas em Cypher; SQL usa CTE recursiva.
- Triple store (sujeito, predicado, objeto) com SPARQL; Datalog define regras recursivas. GraphQL é API, não banco.
- Event sourcing: grava eventos imutáveis no log; o estado atual é derivado deles.
- CQRS: modelo de escrita (eventos) separado de modelos de leitura (views) otimizados para cada consulta.
- DataFrames, matrizes e arrays: modelos de ciência de dados e ML; tabelas viram matrizes numéricas para treinar.
Perguntas-chave
responda de cabeça, depois abraQuando um grafo é melhor que tabelas?
Quando qualquer coisa pode se ligar a qualquer coisa e as consultas percorrem caminhos de tamanho variável (ex.: amigos de amigos, rotas).
Qual o ganho de event sourcing?
Histórico completo e auditável, possibilidade de recriar views novas reprocessando os eventos e de corrigir bugs recalculando o estado.
Por que DataFrames aparecem num livro de sistemas de dados?
Porque análise e treino de modelos de ML manipulam dados como tabelas e matrizes em memória, um modelo diferente do relacional transacional.
Exercícios de fixação
0/5 respondidas1.
"Encontre pessoas que nasceram nos EUA e moram na Europa", com locais aninhados (cidade ⊂ estado ⊂ país ⊂ continente). Qual modelo expressa melhor?
2.
GraphQL, segundo o capítulo, é:
3.
Num sistema de reservas com event sourcing, um bug calculou errado os assentos livres. Como corrigir?
4.
CQRS separa:
5.
Um cientista de dados transforma a tabela de avaliações (usuário, filme, nota) numa matriz usuário × filme para treinar um recomendador. Que modelo ele usa?