4.2. Armazenamento analítico e warehouses na nuvem
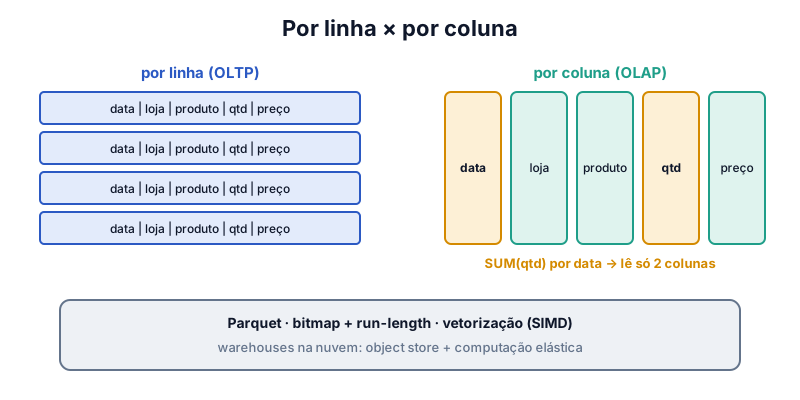
Guardar por coluna permite comprimir e varrer só o necessário; vetorização usa a CPU ao máximo.
Resumo
- Armazenamento colunar: cada coluna num arquivo; a consulta lê só as colunas usadas. Formatos: Parquet, ORC.
- Colunas comprimem bem: bitmap e run-length encoding. Ordenar por uma coluna melhora compressão e filtros.
- Warehouses na nuvem (BigQuery, Snowflake, Redshift): armazenamento em object store, computação elástica.
- Execução: compilação de consultas (gera código) ou vetorização (opera em lotes de valores, usa SIMD).
- View materializada e data cube: agregados pré-calculados; leitura rápida, escrita e flexibilidade custam mais.
Perguntas-chave
responda de cabeça, depois abraPor que colunar acelera análise?
Consultas analíticas usam poucas das centenas de colunas; ler só essas reduz muito o I/O, e valores parecidos lado a lado comprimem melhor.
O que é vetorização na execução de consultas?
Processar um lote de valores de uma coluna por vez num laço apertado, aproveitando cache e instruções SIMD da CPU.
Qual a desvantagem de um data cube?
Só responde às agregações pré-calculadas; filtros por dimensões que não estão no cubo exigem voltar aos dados brutos.
Exercícios de fixação
0/5 respondidas1.
Uma tabela de fatos tem 200 colunas; a consulta usa 4. Qual layout lê menos dados?
2.
A coluna
pais tem 50 valores distintos em 1 bilhão de linhas. Qual técnica comprime bem?3.
O que caracteriza um warehouse cloud native como BigQuery ou Snowflake?
4.
Um motor que aplica um filtro a 1024 valores de uma coluna por vez, num laço simples, usa:
5.
O painel diário soma vendas por loja e mês. Pré-calcular essa soma numa view materializada: